Привет, Хабр! На фоне популярности decision‑моделей мне захотелось познакомиться с их механизмом работы. Объектом исследования я выбрал модель Clef от Cloudflare просто потому, что она больше всего на слуху.
Статья носит познавательный характер и будет интересна тем, кто, как и я, захочет разобраться в работе модели. Фрагменты кода и конфигурации взяты из репозитория авторов.
номер токена в позиции (input_ids[t])
Запрос состоит из state (о чём решаем) и questions (что нужно решить). Пример от Cloudflare:
- создаются автоматически: true, false
- ключи criteria, отсортированные по алфавиту
- индексы списка criteria: «0», «1», …
Для team получается отсортированный по ID список:
Этап 1. encode_record: запрос становится текстом
encode_record склеивает все поля JSON в один промпт и попутно запоминает, где в нём лежит каждый вопрос и каждая опция.
Шаг 1. question_options превращает criteria в список пар (раздел 2).
Шаг 2. Каждая пара заворачивается в маленький словарь:
Шаг 3. Словарь превращается в строку функцией render:
Фиксированный порядок ключей и отсутствие пробелов нужны, чтобы одна и та же опция всегда давала одни и те же токены.
Промпт целиком ([префикс], [state] и т.д. добавлены для наглядности):
После токенизации алгоритм запоминает позиции в промпте вопросов и опций:
Каждый кусок токенизируется отдельно для того, чтобы не происходило склеивание (если токенизировать весь промпт целиком, BPE может склеить конец «OPTION 1: » с началом JSON в один токен).
После этого происходит сдвиг всей схемы на длину префикса и state:
пар чисел, сгруппированы по вопросам
На этом этапе происходит расчёт по всем слоям без головы и применение LayerNorm к последнему выходному слою:
last_hidden_state — по вектору на каждый токен каждой записи батча.
После этапа 2 есть таблица. Номер строки совпадает с номером токена в input_ids. Этап A вырезает из этой таблицы нужные строки (спаны, которые были выделены ранее).
те же позиции, но через input_ids в таблице lm_head
Вектор вопроса
Пусть question_span team = (5, 8), то есть строки 5, 6, 7:
Каждая координата — среднее трёх чисел в столбце: например, (0.2+0.8-0.1)/3=0.3.
Контекстный вектор опции. Пусть option_span billing = (9, 11), то есть строки 9 и 10:
Лексический вектор опции. Позиции те же (9, 11), но строки берутся не из . Сначала по спану читаются номера токенов, потом по этим номерам берутся строки lm_head (номера условные):
Разница между ctx и lex: строка 9 в — это слово «billing», прочитанное Qwen после тикета, и она меняется от запроса к запросу. Строка — слово «billing» само по себе, и она всегда одна и та же.
g и memory. g — просто последняя строка таблицы. memory — все строки, каждая умноженная на . Спаны тут не нужны.
по вектору на вопрос, в порядке вопросов
Прежде чем переходить к следующему этапу распишу какие проекции мы имеем:
- вопроса, которому принадлежит опция
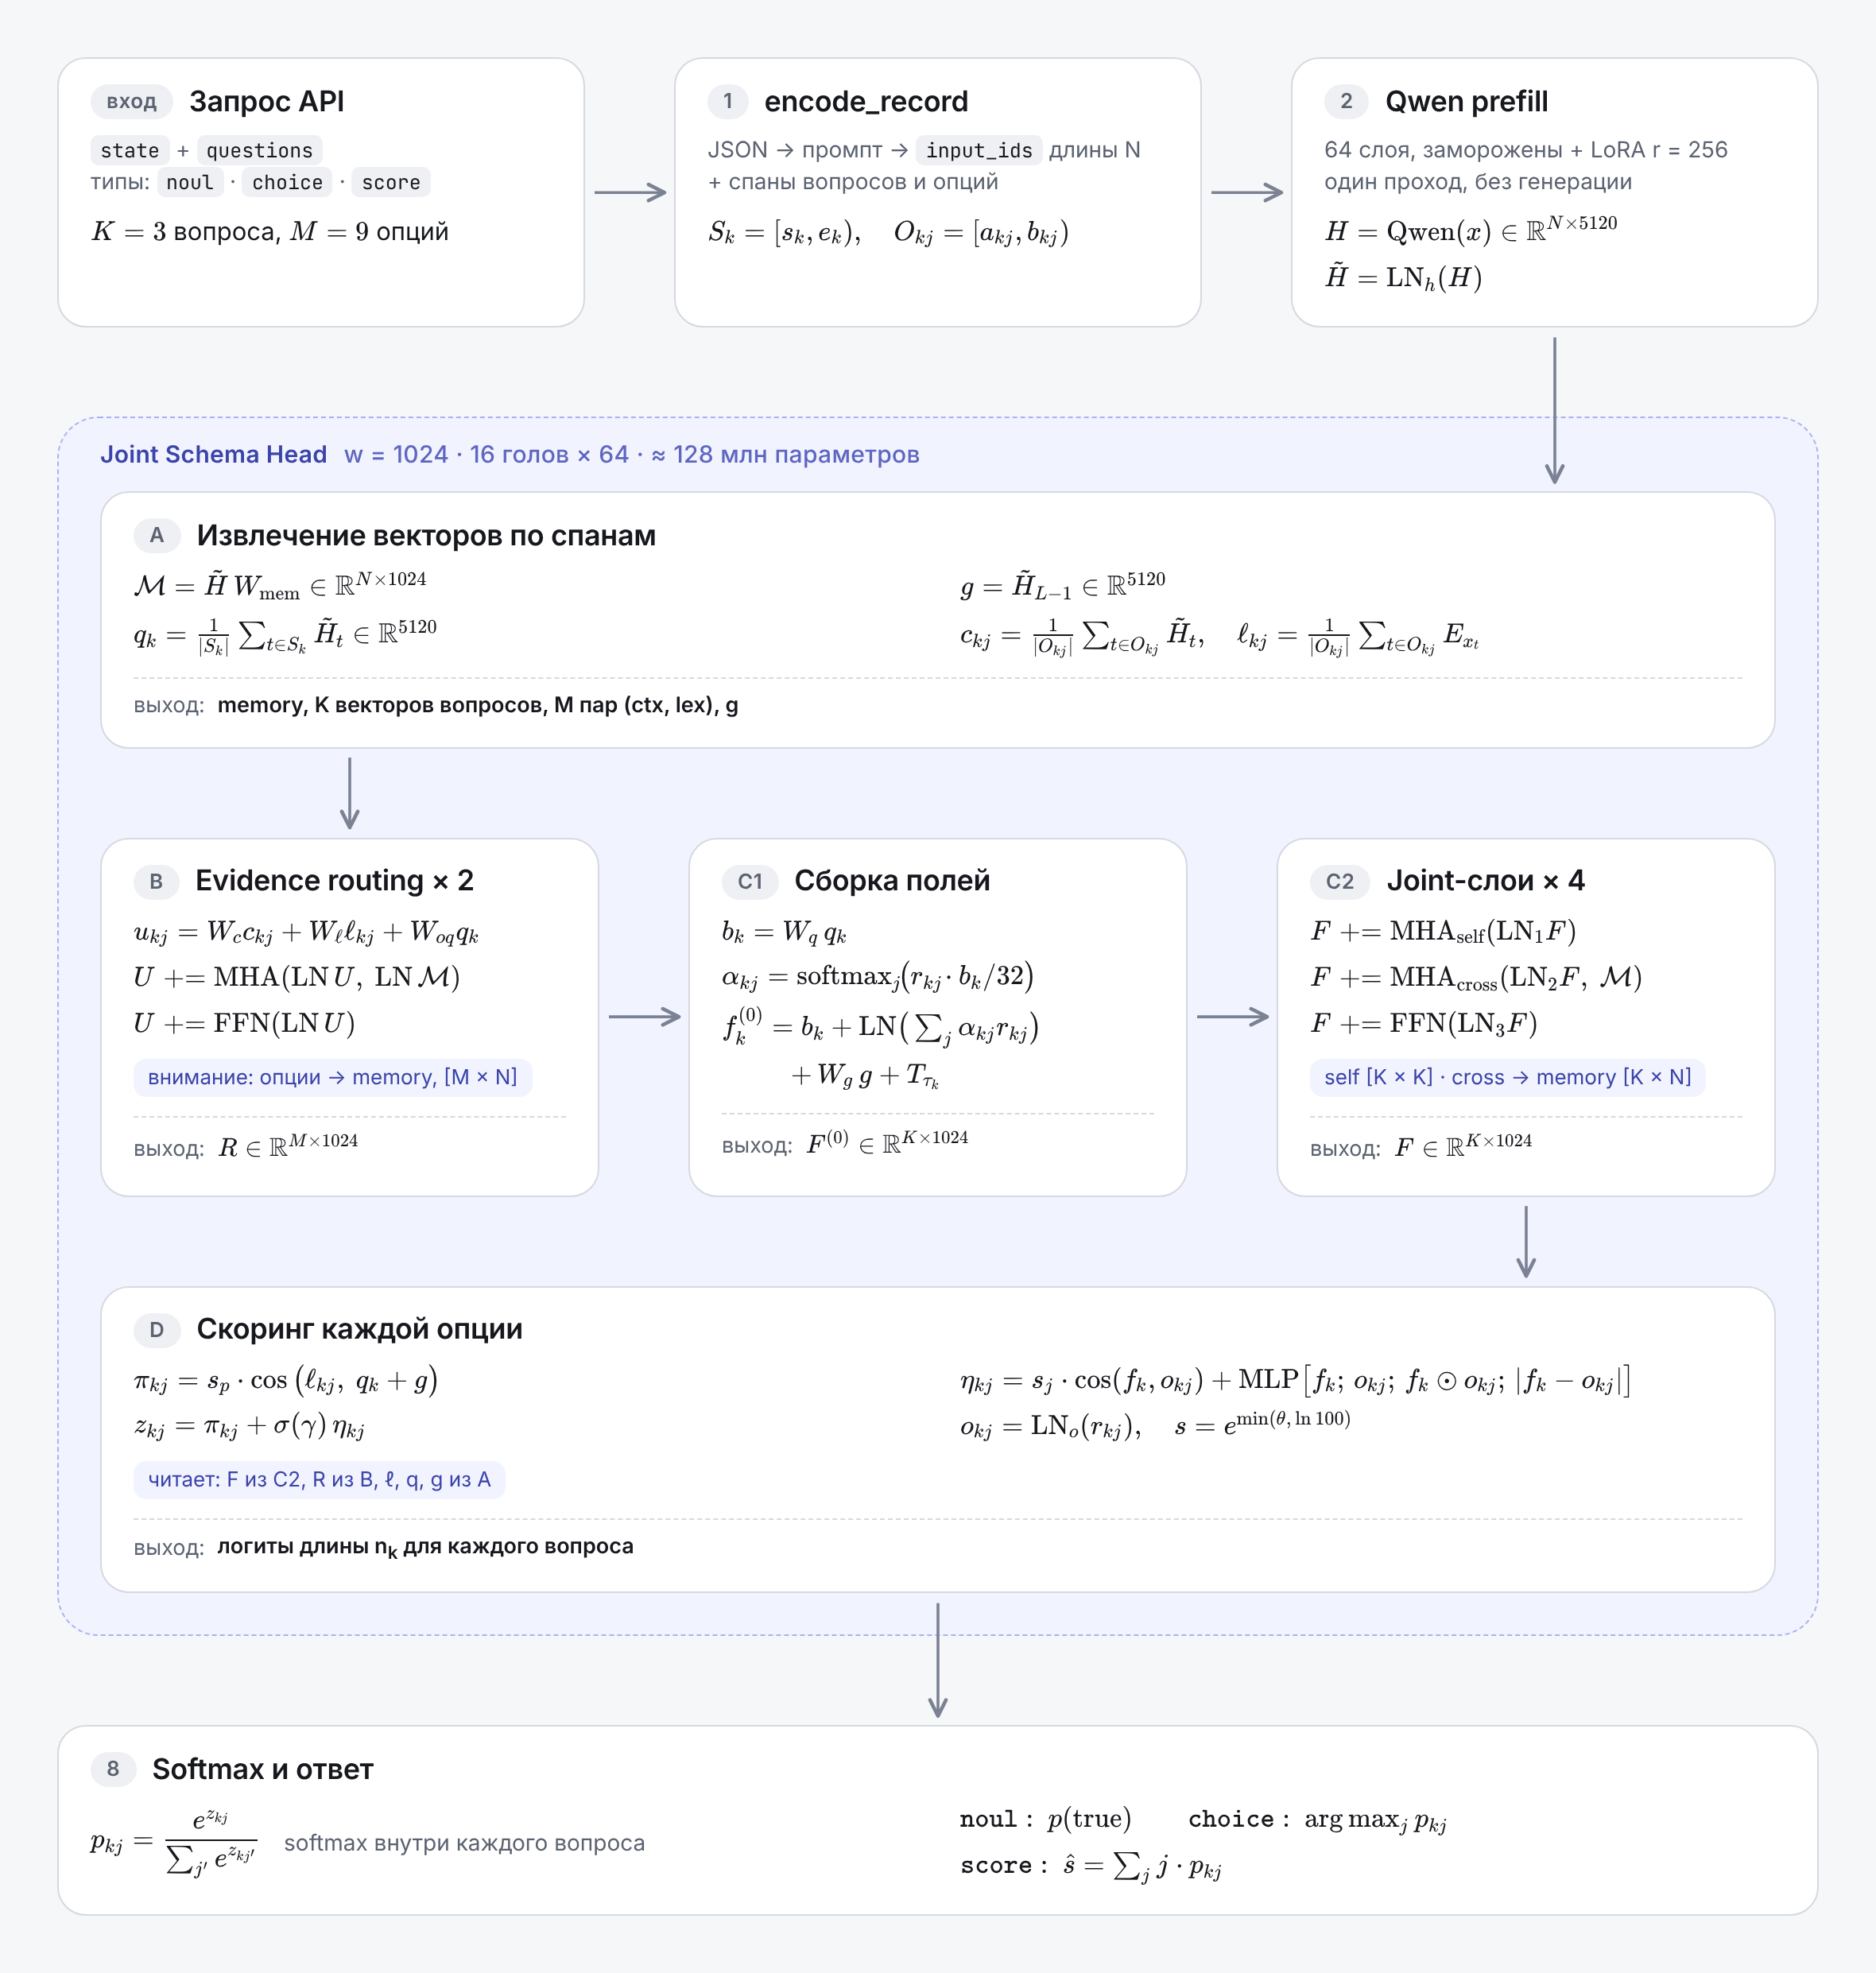
Evidence routing
— этап, в котором каждая опция сама ищет в тексте подтверждения для себя. Это два одинаковых по устройству слоя EvidenceRoutingLayer, каждый со своими весами.
Каждая опция обрабатывается независимо и на выходе получаем распределение «важности» токена всего запроса к конкретной опции.
- что Qwen понял об опции после прочтения тикета;
- что значат слова опции сами по себе;
- к какому вопросу опция относится. Опция ищет в тексте «что-то про себя в контексте этого вопроса».
Опции всех вопросов склеиваются в одну матрицу. Это же представление попадает на вход второго EvidenceRoutingLayer.
Сборка запросов и вызов слоёв в JointSchemaHead.forward
режется обратно на группы вопросов (обогащённые).
Этап C1. Сборка поля для каждого вопроса
На этом этапе для каждого вопроса собирается один вектор — поле. Поле дальше пойдёт в joint‑слои, и в конце с ним будут сравниваться опции.
- — Softmax. Распределение опций каждого вопроса.
- — получаем вектор, который представляет собой общую картину по всем опциям для каждого вопроса.
- — глобальная добавка. Все поля «знают», о чём весь тикет.
- — эмбеддинг типа. Таблица из трёх обучаемых строк: noul, choice, score. Поле знает, как будут читаться его опции.
На этом этапе вопросы впервые узнают друг о друге. Поля обмениваются информацией и ещё раз сверяются с текстом.
TransformerDecoderLayer
— базовый слой декодеров в архитектуре Transformer.
- Self‑attention: вопросы смотрят друг на друга
Запросы, ключи и значения берутся из одних и тех же полей (16 голов по 64), матрица внимания каждой головы имеет размер:
Строка — кто смотрит, столбец — на кого. Каждое поле смотрит на все три, включая себя.
- Cross‑attention: поля читают текст
Смысл: после подблока 1 поле уже знает, что думают другие вопросы, и перечитывает текст с этим знанием. Например, поле severity, получив от urgent сигнал «срочно», может внимательнее посмотреть на «every customer».
Объявление скорера и масштабов в _init_:
Логит собирается из двух независимых частей:
- prior работает только с , в пространстве Qwen (5120);
- joint работает только с и в пространстве головы (1024).
— смысл вопроса плюс смысл всего запроса.
Лексический вектор — словарный смысл слов опции без контекста.
- — обучаемый коэффициент масштабирования
2c. MLP (residual_scorer в коде) по признакам пары. Для каждой пары собирается вектор длиной 4096:
Применение Softmax в рамках вопроса:
В этой статье я постарался осветить процесс работы модели принятия решений Clef. Если вы заметили неточность в излагаемом материале — буду рад услышать ваше объяснение и критику для более глубокого понимания работы!
Claude за полчаса разгадал загадку АНБ, которой больше 25 лет
Четверть века вокруг одного из главных стандартов современной криптографии держалась почти детективная интрига. В 2000 году американский институт стандартов NIST утвердил набор эллиптических кривых от P‑192 до P‑521 — сегодня на P‑256 держатся подписи сертификатов сайтов, токены входа и защищённые чипы телефонов. Параметры этих кривых выведены из начальных значений (seed), которые Агентство национальной безопасности США передало в стандарт без всяких объяснений. 16 октября 2026 года команда Anthropic сообщила, что её внутренняя исследовательская модель Claude меньше чем за полчаса нашла происхождение этих чисел, а криптограф Филиппо Вальсорда, объявивший за разгадку награду, подтвердил правильность решения.
Как я выгружал 1,8 TB с Яндекс Диска после аварии в дата‑центрах
Anthropic забанила мой Claude и отдала в экспорте только телефон. Теперь мне отвечает Grok в парике.