300 тысяч job в час: как неправильный порядок Dispose в Serilog устроил утечку памяти
Периодически срабатывали алерты по памяти и CPU. Я начал расследование. Но расследование в итоге привело совсем в другое место — к Serilog.Context.
В результате удалось решить две независимые проблемы:
- Длительное ожидание рабочих процессов;
- Накопление объектов контекста логирования (рост кучи).
Длительное ожидание рабочих процессов
На первом этапе я посмотрел, какие endpoint вызываются чаще всего. Стало видно, что несколько endpoint возвращают статичные данные: словари, переводы — которые редко меняются. Вместо постоянного обращения к базе данных был добавлен кэш. После оптимизации изменения были задеплоены в production. Но примерно в течение следующей недели стало видно, что проблема возвращается — ресурсы начали снова постепенно расти, а алерты снова начали срабатывать. Первоначальная оптимизация действительно помогла, но не устранила основную проблему.
Параллельно появился инцидент. В пиковый период сервис получал порядка 300k HTTP-запросов, каждый из которых приводил к постановке фонового job в Hangfire. Запросы поступают не одновременно, а распределяются в течение часа. Поэтому нагрузка имеет характерный пик.
Именно в этот момент пользователь отправил запрос, у него произошел таймаут, а по логам видно, что между началом и завершением job прошло 1.5 часа.
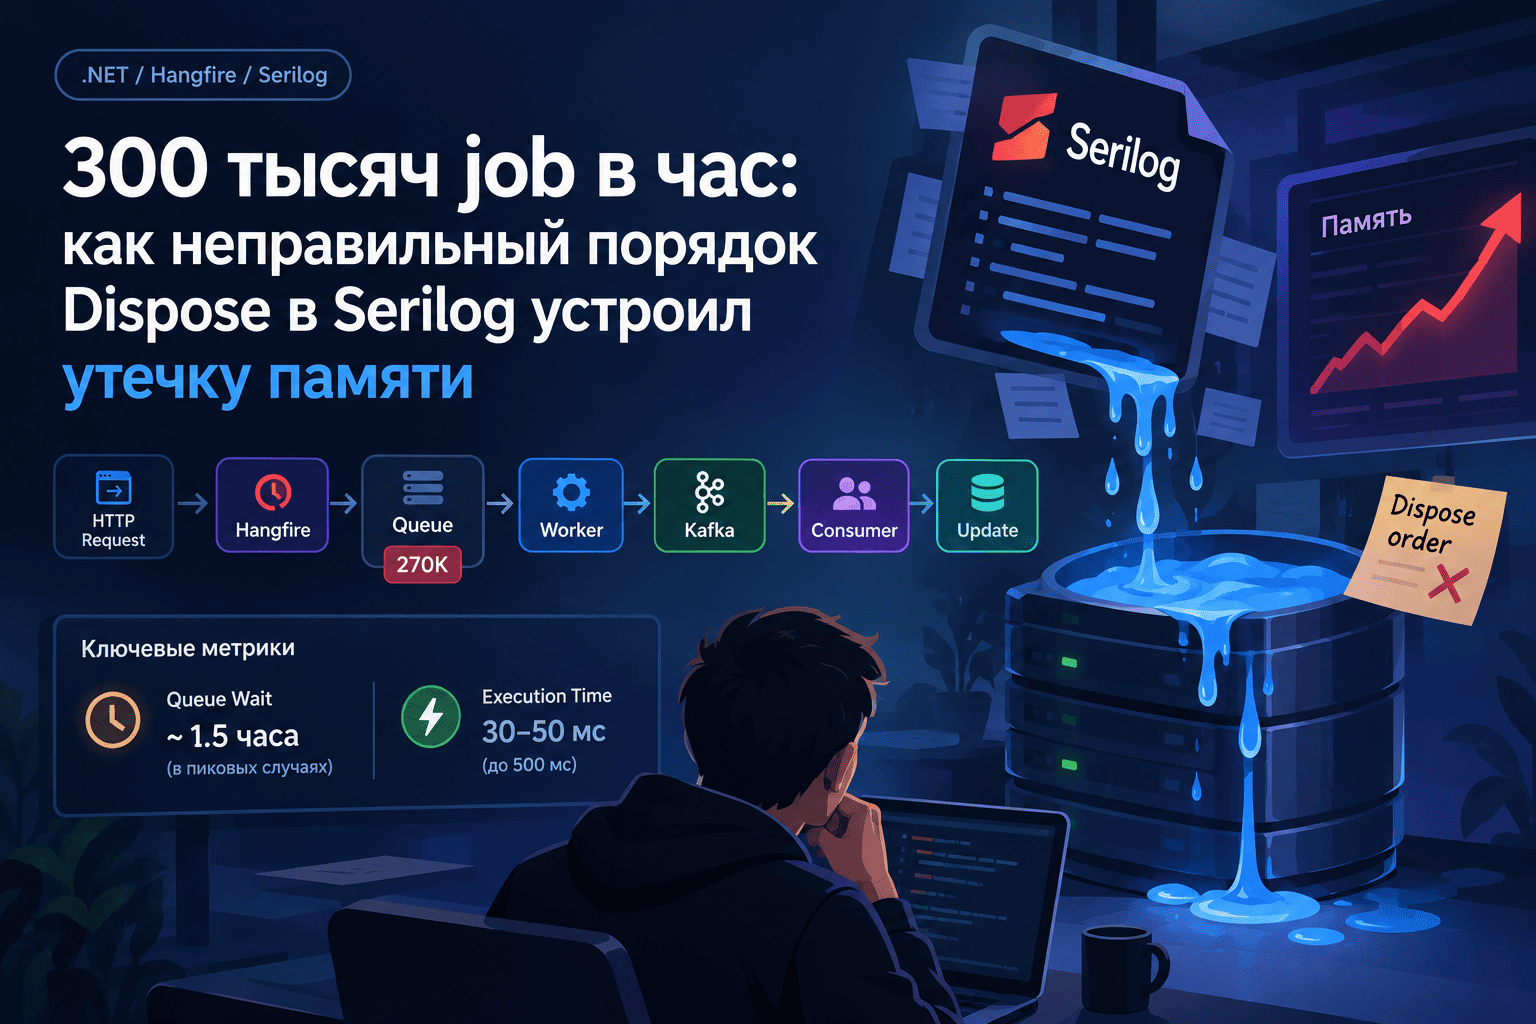
Проблема заключалась в том, что обычные рабочие задачи и массовые запросы использовали одну очередь. В момент инцидента сервис работал на 8 pod’ах. Каждый pod запускал один worker, слушавший одну и ту же очередь Default. Два poda были добавлены autoscaling’ом. Таким образом, суммарная worker capacity для обеих категорий задач составляла восемь обработчиков. Когда приходила массовая нагрузка, очередь быстро увеличивалась. В какой-то момент в очереди находилось 270k необработанных job. При этом пропускная способность составляла 30–50 job/с.
И тут расчёт хорошо объясняет наблюдаемую задержку:
- 270k / 50 ≈ 5 400 секунд ≈ 90 минут;
- 270k / 40 ≈ 6 750 секунд ≈ 112 минут.
Это объясняет поведение, когда пользователь ждал 1.5 часа.
На этом этапе я добавил важные метрики, мониторинг двух ключевых интервалов: сколько job находилось в очереди и как быстро они выполнялись.
Здесь обнаружилось самое интересное
Но перед этим job могла ожидать в очереди 1.5 часа. Проблема была не в том, что одна job выполнялась 1.5 часа, а в том, что она часами ждала свободного воркера.
После этого стало понятно, что массовая нагрузка не должна конкурировать с обычными рабочими запросами. Для аналитической очереди были увеличены воркеры до двух. Также была сделана оптимизация работы в job, в результате аналитическая очередь стала разгребаться значительно быстрее. Задержка между постановкой задачи и началом выполнения снизилась до 5 минут, а количество подов сократилось до пяти: автоскейлинг больше не срабатывал. Проблема пользователя была решена. Теперь его задача не должна ждать, пока отработают job из аналитики.
На этом этапе расследование стало интереснее. Проблема с очередью была решена. Но спустя некоторое время снова стало видно: память растет.
График памяти не возвращался к исходному уровню — значит, это уже другая проблема. Это был хороший момент, чтобы разделить две независимые проблемы:
- Очередь — долгое ожидание job, решено разделением очередей;
- Рост кучи — требовал отдельного расследования.
Сначала казалось, что всё является одной большой проблемой производительности. На практике оказалось, что один инцидент маскировал две разные проблемы.
Повторяемость и сбор дампа
Проблему необходимо воспроизвести в тестовой среде. В данном случае я использовал нагрузочное тестирование через NBomber. Сценарий имитировал нагрузку 10 RPS в течение 7 часов. И результат был показательным: на тестовой среде память начала вести себя так же, как на проде.
Теперь можно было снимать dump и исследовать состояние процесса в момент деградации.
Следующий этап — посмотреть, что реально находится в куче. В контейнере был собран dump.
Если память контейнера закончится, процесс может зависнуть, а контейнер — перезапуститься. Далее можно использовать команды для снятия и анализа dump.
Анализ heap dump
В dump среди объектов сразу бросились в глаза структуры Serilog: Serilog.Core.Enrichers.PropertyEnricher.
Чтобы убедиться, что это не случайный всплеск аллокаций, я сравнил статистику кучи из двух dump, снятых на разных этапах нагрузки.
Это уже не просто общий рост потребления памяти: одновременно увеличивалось количество объектов, связанных с контекстом логирования Serilog.
Поскольку недавно в GlobalFilter добавляли функционал, связанный с логированием, я сразу проверил его. После этого я посмотрел, где именно создаются эти объекты: метод OnPerforming создавал два скопа.
Понимание поведения LogContext.PushProperty
Контекст ведёт себя как стек. Сначала был создан scope для CorrelationId, затем scope для JobId. Поэтому освобождать их нужно в обратном порядке. LogContext.PushProperty возвращает не обычный disposable, а bookmark — Dispose не «убирает верхний элемент стека», а восстанавливает AsyncLocal‑состояние на тот момент, когда именно этот Push был сделан.
Если вызывать Dispose не в обратном порядке, первый Dispose откатывает стек к пустому состоянию, а второй — откатывает его к состоянию на момент своего push, где первый scope уже был записан. Он буквально «воскресает» после своего же Dispose.
То есть для каждой выполняемой job создавались два logging scope. Из‑за неправильного порядка вызова Dispose один из scope фактически не освобождался и оставался активным в LogContext, а связанные объекты накапливались в куче.
Фикс и проверка
Финальный прогон: мы нашли подозрительный код и исправили его. Нужно было доказать, что изменение действительно устраняет проблему. Поэтому тот же нагрузочный сценарий был запущен повторно.
После фикса рост прекратился. Ресурсы стабилизировались примерно в районе 30–40% без прежнего постоянного накопления.
Итоги
Массовая нагрузка использовала ту же очередь Hangfire, что и обычные рабочие задачи. При накоплении сотен тысяч job:
- Воркеры были заняты массовыми задачами;
- Обычная задача могла ждать около полутора часов.
Решение: разделение очередей + увеличение количества воркеров для analytics + оптимизация запроса.
Причина №2 — накопление Serilog context:
- На каждую job создавались два scope через LogContext.PushProperty, но Dispose вызывался не в обратном порядке — из‑за этого один из scope фактически не освобождался и оставался в активном LogContext, а связанные объекты накапливались в куче.
- Один PropertyEnricher занимал относительно немного памяти сам по себе. Но когда таких объектов становится сотни тысяч, проблема начинает проявляться. Именно поэтому она не была заметна сразу: при коротком горизонте метрик рост легко пропустить. Нужны метрики, которые хранятся хотя бы несколько дней.
Выводы практического характера:
- Не смешивать массовые аналитические нагрузки и обычные рабочие задачи в одной очереди без выделения capacity;
- Следить за временем ожидания job в очереди и за скоростью их обработки;
- При использовании LogContext.PushProperty всегда Dispose в обратном порядке создания или использовать конструкции, гарантирующие правильный порядок освобождения, чтобы не оставлять старые scope’ы в AsyncLocal и не накапливать объекты в куче.